.

Сделать репост в соц сети!

Показаны сообщения с ярлыком регрессионный анализ. Показать все сообщения

понедельник, 14 августа 2017 г.

Изучаем регрессию дальше


Задача

В предыдущей статье «Регрессия: Как начать предсказывать» мы коснулись темы простой линейной регрессии. Сегодня мы продолжим погружаться в эту интересную тему.

Итак, задача на сегодня у нас следующая. Есть данные участников мастер-класса по скорочтению (126 наблюдений). Мы построим модель прогноза Количества прочитанных книг за год на основании Скорости чтения человека. Т.е. Количество книг это зависимая переменная, а Скорость чтения – это независимая переменная (предиктор).

В предыдущей статье мы уже строили простую линейную регрессию.

В этой статье мы задействуем следующие методы:
·        Полиномиальная регрессия
·        Decision Tree («Дерево решений»)
·        Random Forest («Случайный лес»)
·        SVR (метод опорных векторов)
·        KNN (метод k-ближайших соседей)

После того как мы построим все эти модели, мы их протестируем на тестовой выборке. И после этого посмотрим, какая модель лучше всего справилась с заданием. Т.е. выберем лучшую.

Подготовка данных

У нас есть набор данных участников мастер-классов по скорочтению. База, на основании которой мы будем строить нашу модель.

Загрузить данные в R можно следующей командой:
dataset <- read.csv("SpeedReading_4_Groups.csv", sep = ";")
Посмотреть на первые шесть строк нашего датасета можно так:

head(dataset)

Никакой особой подготовки или преобразований наши данные не требуют.

Нам только нужно разделить наши данные на тренировочный и тестовый наборы данных. Т.е. на тренировочном датасете мы будем тренировать наши модели, а на тестовом – будем их тестировать.

Разделить наши данные на два датасета можно следующим кодом:
trindex = sample(1:nrow(dataset), nrow(dataset)*0.8)
training_set = dataset [trindex, ]
test_set = dataset [-trindex, ]

В результате такой операции мы получим два датасета:
training_set – тренировочные данные
test_set – тестовые данные

При этом данные будут распределены в пропорции 4/5. Т.е. 80% данных пойдет в тренировочные датасет, а 20% оставшихся в тестовый.

Вспоминаем линейную регрессию

Давайте построим простую линейную регрессию с одной независимой переменной, как мы это делали в прошлой статье.

У нас получится следующая модель:

А также давайте визуализируем данную модель.

Линейные модели мы можем использовать, когда выполняются определенные условия. Такие, как, например, линейная взаимосвязь и нормальное распределение наших переменных.

Тест на нормальность распределения наших переменных:

А также гистограммы:


Т.е. наша зависима переменная (Количество прочитанных книг) не прошла тест на нормальность. Кроме того, если посмотреть на график scatter plot, где отображена взаимосвязь наших двух переменных, то мы увидим, что связаны они не совсем линейно.

Нелинейные модели

Теперь давайте попробуем решить нашу задачку при помощи нелинейных моделей.

Полиномиальная модель

Построить такую модель совсем несложно. Достаточно добавить несколько полиномов. Например, это можно сделать так:
training_set$Level2 = training_set$Скорость.чтения^2
training_set$Level3 = training_set$Скорость.чтения^3
training_set$Level4 = training_set$Скорость.чтения^4
poly_reg = lm(Сколько.книг~Скорость.чтения+Level2+Level3+Level4, data = training_set)
summary(poly_reg)

В результате выполнения данных команд мы получим следующую модель:

Интерпретация такой модели ничем не отличается от линейной модели. Здесь мы можем увидеть все предикторы, а также посмотреть чему равняется R2 нашей модели.

Давайте визуализируем и данную модель:

Теперь давайте построим и другие типы моделей.

·        Decision Tree («Дерево решений»)
·        Random Forest («Случайный лес»)
·        SVR (Метод опорных векторов)
·        KNN (Метод k-ближайшего соседа)

У данных методов есть настраиваемые параметры. В данной статье мы не будем детально вдаваться во все подробности такой настройки, а попробуем использовать некие “стандартные” величины.

Decision Tree («Дерево решений»)

Для построения модели Decision Tree достаточно выполнить следующий код:
dTree <-  rpart(formula = Сколько.книг ~ Скорость.чтения,
                  data = training_set,
                  control = rpart.control(minsplit = 3))

И давайте также визуализируем полученный результат:


Мы видим, что данный метод совсем по-другому визуально пытается описать наши данные в отличие от простой линейной регрессии.

Random Forest («Случайный лес»)

Двигаемся дальше. Теперь метод Random Forest. Для построения регрессионной модели данным методом необходимо выполнить следующий код:
rndForest = randomForest(x = training_set[5],
                         y = training_set$Сколько.книг,
                         ntree = 5)

И давайте посмотрим на визуализацию нашей новой модели:


Из рисунка видно, что данный метод еще более «изощрённо» пытается описать наши данные.

SVR (Метод опорных векторов)

Переходим к следующему методу – SVR (Метод опорных векторов). Для построения регрессионной модели, необходимо выполнить следующую строку кода:
fitSVM = svm(formula = Сколько.книг ~ Скорость.чтения,
                data = training_set,
                type = 'eps-regression',
                kernel = 'radial')

И также давайте посмотрим на графическое отображение нашей новой модели:


Рисунок показывает нам, что данный метод строит более плавную линию для описания наших данных.

KNN (Метод k-ближайшего соседа)

И последний метод k-ближайшего соседа. Для построения регрессионной модели при помощи данного метода, нам необходимо выполнить следующий код:
fitKNN <- knn.reg(training_set[5], test_set[5], training_set[,4], k = 5)

И визуализируем нашу модель на графике:

Из рисунка мы видим, что метод KNN чем-то похож на визуализацию Random Forest. Такая же ломанная кривая линия.

Тестируем и выбираем лучшую модель

Теперь давайте протестируем все наши 6 моделей на тестовом наборе данных. Если помните в самом начале мы разделили наш датасет на две части: тренировочный датасет и тестовый датасет. До этого момента мы использовали тренировочный датасет. А теперь мы воспользуемся тестовыми данными.

Т.е. ответим на вопрос, а какая модель лучше других может более точно предсказывать значения Количества прочитанных книг на новых данных.

В этом нам помогут три показателя:
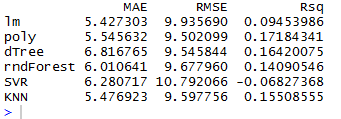
MAE (Mean Absolute Error) – Средняя абсолютная ошибка между предсказанной и реальной величиной. Чем меньше ошибка, тем лучше.
RMSE (Root Mean Squared Error) – Квадратный корень из среднеквадратичной ошибки между предсказанной и реальной величиной. От МАЕ отличается тем, что «штрафует» большие ошибки сильнее. Чем меньше, тем лучше.
Rsq (коэффициент детерминации) – это доля дисперсии зависимой переменной, объяснённая нашей независимой переменной или переменными. Чем он больше, тем лучше.

После несложных вычислений и применения наших 6-ти моделей к тестовым данным, мы получим вот такую таблицу:

Давайте выберем трех лидеров по каждому показателю:
МАЕ: линейная, KNN и полиномиальная
RMSE: полиномиальная, Decision Tree и KNN
Rsq: полиномиальная, Decision Tree и KNN

По всем трем показателям у нас лидируют две модели: полиномиальная и KNN.

Ранее я говорил о том, что метод KNN-регрессии имеет настраиваемый параметр. Этот параметр (k) задается в формуле. Когда мы строили модель первый раз, мы задали стандартное значение 5. Но давайте теперь попробуем подобрать оптимальное значение (k), при котором наша ошибка RMSE будет минимальной.

Запустив совсем несложный цикл, мы получим следующий результат:


Т.е. наша ошибка RMSE будет минимальной при k=3. Давайте еще раз построим модель KNN с учетом нового значения k=3.
fitKNN <- knn.reg(training_set[5], test_set[5], training_set[,4], k = 3)

И теперь еще раз рассчитаем все наши параметры для выбора лучшей модели:


Мы видим, что настройка параметра k дала свои результаты. Теперь у нас у метода KNN самая минимальная ошибка RMSE и самый большой Rsq.
Мы могли бы тюнинговать и другие методы, но это уже материал для новой статьи.

Теперь визуализируем все наши модели (линии) и на эти же графики точками нанесем данные из тестового датасета. Так мы сможем понаблюдать воочию, насколько точно наши модели описывали новые данные.

Ниже представлен именно такой график:

Выводы

В этой статье мы познакомились с несколькими нелинейными методами регрессии и решили поставленную в начале задачу. А именно:
        1)    Построили модель регрессии различными методами
        2)    Рассчитали критерии точности моделей для выбора наилучшей
        3)    Настроили k-параметр в KNN методе
        4)    Выбрали наилучшую модель и визуализировали итоговый результат

вторник, 25 февраля 2014 г.

Выбор контрольной группы в программе R при использовании категориальных переменных в регрессионном анализе

При использовании категориальных переменных в регрессионном анализе исследователю бывает важно задать контрольную группу самостоятельно.
Пост - инструментальная подсказка для тех, кто пользуется R. В качестве кейса беру результаты нашего опроса по исследованию факторов текучести персонала (поучаствуйте заодно). В качестве независимой категориальной переменной я беру источники трафика подбора персонала (через какие каналы кандидаты узнали о вакансии).
Знакомые
friend
Социальные сети
 sm
Джоб сайты
jobsites
Объявление в газете
paper
Раздел Вакансии компании (карьерный портал)
cariersite
Работодатель сам вышел на Вас
direct
Вы обратились непосредственно в саму компанию (отдел кадров и т.п.)
self_direct
Кадровое агентство
KA
Центр занятости
Center_job
другое
etc
В R по умолчанию контрольная группа задается первой в алфавитном порядке, т.е. если у вас "арбузы", "апельсины", "мандарины", то по умолчанию контрольной группой будет "апельсины".

четверг, 28 ноября 2013 г.

Анализ влияния активности группы в linkedin на рост числа членов группы

Идея банальна: я хотел проверить гипотезу о том, что активность группы влияет на число новых членов группы.
Новая дискуссия, новый коммент отображается в ленте того, кто постит, это видят друзья запостившего, соответственно, они могут пройти по ссылкам и принять решение присоединиться к группе.

Благодарность

Прежде всего хочу выразить благодарность Кириллу Захарову - не знаю, как представить, наверное напишу, что профессия и призвание - аналитик. Кирилл несколько часов подарил мне, чтобы объяснить, как скачивать информацию с Dashboard группы в Линке информацию. И без него этот пост просто не появился бы.
В итоге я сегодня менее чем за 15 минут скачал инфо о количестве новых членах, количестве постов и комментов в трех группах на Линкедине.

Результаты

Результаты неоднозначные, прошу помощи в интерпретации: если есть какие-то идеи, буду благодарен
Результаты посчитал по трем группам, выбрав по принципу максимального разброса по показателям активности и роста
Таблица средних значений по группам

новые члены
комменты
дискуссии
HR Professionals Network Russia, CIS countries and Eastern Europe
18,7
2,8
10,0
HRM.RU
45,1
53,1
8,4
SELL YOUR HEAD
253,6
318,5
36,5
Я посчитал по каждой группе линейную регрессию, где Y - новые члены группы за неделю, Х1 - количество комментов в неделю, а Х2 - количество новых дискуссий в неделю.

вторник, 15 октября 2013 г.

Прогноз уровня зарплаты (кейсы регрессионного анализа)

Выкладываю в качестве кейсов две таблицы с данными. Данные взяты из курсf по статистике Statistics One, который проводят на сайте coursera.org преподаватели Princeton Universityю См подробнее мой пост MOOC - опыт нового формата обучения
Данные выкладываю ниже. Число респондентов для обоих кейсов - 200. Думаю, разберетесь, что к чему. Обращаюсь в первую очередь к участникам своего семинара Аналитика для HR. Были просьбы сделать курс по Аналитике с домашними заданиями - вот в качестве ответа даю задание. Принимаю ваши решения - файлы в формате excel на почту edvb()yandex.ru. Сам я вычисления проводил в программе R, но повторил позже в excel, поэтому вы получите идентичные результаты в excel.
Но это относится далеко не только к участникам семинара по Аналитике, но и ко всем, кому интересно применять математические методы в HR.

Кейс №1 Как зависит уровень вознаграждения от опыта работы и образования.

В таблице указан уровень вознаграждения, опыт работы в сфере, количество пройденных курсов.

понедельник, 11 марта 2013 г.

Формула лидерства


После статьи Как Google стал №3 в списке самых дорогих компаний Мира, используя People Analytics подумал, а почему бы не сделать тоже самое?
Даю формулу / уравнение «Как стать лидером»
Пост в продолжение наших исследований лидерства
Идея поста простая: определить не просто составляющие лидерства (мы их выявили в см. Портрет российского лидера), а вес этих составляющих, фактически акценты лидерства
Сразу хочется предостеречь критиков: прежде чем выдавать критику (а базовое утверждение критиков – выборка исследования нерепрезентативна), сначала почитайте про цели исследования, метод и математический аппарат.
И если вы слышали о применении бинарного логистического уравнения регрессии, то, уверен, мы найдем общий язык.

суббота, 9 марта 2013 г.

Что такое BigData в HR?


Что такое BigData в HR?

Пост короткий
В Анкете вовлеченности Hewitt 47 вопросов.
Первый звучит так:
Насколько Вы в целом удовлетворены работой в этой компании?
И семь вариантов ответов от полной неудовлетворенности до полной удовлетворенности.
Далее 46 вопросов, вопросов, оказывающих влияние на вовлеченность персонала.
Hewitt не сообщает общей формулы вычисления вовлеченности персонала, и многие компании переживают по этому поводу.
Мне кажется, что поводов для переживаний совершенно нет, поскольку каждая компания может создавать свою формулу вовлеченности персонала.

Процедура создания

Исхожу из простой банальной мысли, что 46 переменных не могут оказывать равномерное влияние на одну независимую переменную – в нашем случае вопрос об удовлетворенности, поэтому наша задача – создать уравнение регрессии (регрессионный анализ) меньшим набором и разными весами влияющих переменных.
Здесь только одна закавыка: в уравнении регрессии не должны быть переменные с высокой корреляцией между собой. А таких переменных будет наверняка очень много – вопросы пересекаются по смыслу. Следовательно, мы сначала должны провести факторный анализ, чтобы выявить все высокие степени корреляций.
Поэтому в итоге у нас получится уравнение ну наверное с 5-12 переменными.
И собственно задача HR – в управлении этим набором переменных.
Одним важным следствием получения уравнения регрессии является то, что набор получаемых переменных и коэффициенты регрессии являются показателями корпоративной культуры – ибо есть подозрение, что в каждой организации будет свой уникальный набор переменных и коэффициентов регрессии.
Собственно это и есть технология BigData в HR. Одна их технологий. 

Резюме

Если технология понравилась - можете пригласить меня для создания своего уравнения вовлеченности персонала (edvb()yandex.ru)

среда, 6 февраля 2013 г.

Матстатистика для T&D


Сегодня провел вебинар по матстатистике для T&D в проекте T&D Dive
Рассказал за 1,5 часа про 4 критерия:


сам удивляюсь, как это сделал
Запомнилось, как я дал непростую задачку, а одна девушка выдала: "...это означает, что с т.з. оценки эффективности обучения нет разницы, как учить - дистанционно или очно..."
Пять баллов! мы решили совершенно практическую задачку и простыми средствами
В ходе подготовки к вебинару обнаружил, что множественная регрессия считается в excel - это означает, что я смогу давать регрессию инструментально - готовую к применению в полевых условиях
В excel есть инструменты работы с регрессией - коэффициент детерминации считается, проверяются факторы и т.п... Т.е. загорелся я идеей передать множественную регрессию в руки всех HR, а не только элиты из comp&ben, которые применяют его при оценке уровня оплаты труда
Очень надеюсь, что участники сделают домашнее задание
И все же главное в статистике - не выбор критерия - не хочу вас обманывать или точнее, вводить в заблуждение. Важно не количество критериев и не то, какие критерии дал. Суть вебинара не в критериях. Выбор критерия дело не самое важное
Важнее создать модель. Модель оценки эффективности ситуации обучения, если мы говорим про обучение.
Я бы рекомендовал не хвататься за глобальные проекты. Попробовать можно с простого курса или семинара. Понять, что хотим и как измерить. Это и будет моделью. Если понимаем, то само обучение становится более внятным и управляемым.
Для меня это очередная ступенька к семинару Аналитика для HR в Киеве 21-22 июня этого года
Приглашаю

четверг, 9 августа 2012 г.

Зачем нужна модель Киркпатрика


Зачем нужна модель Киркпатрика

Рассуждения про модель Киркпатрика, оценку эффективности обучения, регрессионный анализ и, главное, отношение HR-а к этому.
Вслед вебинару на нашем портале Матстатистика для HR-3
Мы рассматривали сегодня регрессионный анализ. Было при этом максимально человек 25. Что очень мало для нашего портала.
Если бы вебинар был по теме Модель Киркпатрика, уверяю вас, было бы человек 90-120. От чего так? Я не буду отвечать прямо, дабы не обидеть рынок, а поррассуждаю.

четверг, 12 июля 2012 г.

Почему я против HR-бренда


Вчера в посте Чем отличаются HR-метрики от KPI? Получил коммент (цитирую часть):
«…Сформулируем, какой у нас должен быть HRбренд - напр, мы современны (назовем это миссией) - затем сделаем операционализацию понятий (мы современны - значит мы знаем о последних новинках и продаем эти новинки, у нас современная система мотивации и т.п. и сотрудники, рынок труда с потенциальными кандидатами знают об этом), затем сформулируем цели (донести до целевой группы что мы современны к ...дата, изменить систему мотивации так-то к...) - это будут KPI рук-лей отделов HR. Они разработают методы достижения, реализуют. А потом мы измеряем, сделали ли они, знают ли сотрудники и рынок труда, смотрим, что это нам дало. Ведь ошибка может быть на любом уровне – от формулировки страт цели, операционализации понятий до выбора метода..»
Схема логична и понятна и критиковать не за что. Ну, разве что только за то, что мы находимся в разных идеологиях.

пятница, 25 мая 2012 г.

Валидность теста в психологии и бизнесе


Пост в продолжение нескольких дискуссий в последнее время о валидности тестов, пригодности использования их в бизнесе и т.п…
По ощущениям, у многих специалистов сложилось мистическое отношение к валидности теста: достаточно сказать «валидность теста 80 %», и дружно киваем головами. Или распространенный разговор:
- Стоит ли применять этот тест?
- Думаю, да, его валидность достаточно высокая. Я ему доверяю.
За этими разговорами проглядывает полное непонимание предмета. Тем более, в приложении к бизнесу.
Во – первых, скажу банальность: валидность бывает разная. Очевидная и прогностическая валидности вообще то про разное.
Во – вторых, валидность теста – валидность психологическая. Поясню
Ближе всего бизнесу валидность прогностическая: то, насколько тест может предсказать будущее поведение человека. Но психолог, определяя прогностическую валидность, имеет ввиду некие поведенческие реакции, связанные с тестом. Если мы говорим о шкале A 16-ти факторного теста Кетелла, то высокие показатели по шкале должны подсказать нам, что человек не будет сидеть молча в уголке, а вступать в общение с окружающими и т.п..
Но бизнес интересует иная валидность: связь с будущими бизнес-результатами. В случае с вышеприведенным примером шкалы теста Кетелла бизнес не инетерсует, общителен ли товарисч, а «лишь» насколько данная шкала будет влиять на уровень продаж данного товарисча.
Скажите, такие вещи психологи делают, валидизируя свои тесты? Скорее всего нет, согласны?
Чья это задача? Задача бизнеса, задача HR
Я когда-то делал такую работу с когнитивными тестами (тестами способностей) в отношении операционистов банка. Проводил регрессионный анализ результатов тестов отбора при приеме на работу и результатов деятельности этих же специалистов спустя полгода работы в банке
Вчера на вебинаре Матстатистика для HR услышал другой – аналогичный - пример : психолог компании проводит регрессионный анализ для определения пригодности тестов при отборе персонала.
Может быть стоит ввести понятие валидности процедуры оценки? Для бизнеса? К сожалению или счастью эта валидность именно процедуры. Она привязана к конкретному бизнесу, к конкретным условиям, к конкретной компании. Поле работы – непаханное…
Слышали ли вы о том, что психологи или бизнес консультанты выполняют такую услугу? Я – нет.
Причин здесь может быть несколько.
·         Профессиональные психологи могут вообще не думать в терминах бизнеса и задачки бизнеса их не интересуют
·         Продавцов теста такая процедура «не интересует» принципиально: а «вдруг» выяснить, что связь между результатами теста и результатами бизнеса близка к нулю?
·         Hr чаще всего просто не профессиональны в этом вопросе: не владеют инструментарием. Или не имеют ресурсов
В итоге все споры по поводу применимости тестов в бизнесе сводятся к эмоциям и гаданию на кофейной гуще: нравится / не нравится тестирование…
Но прецеденты есть. Это обнадеживает
ПыСы. Хорошо бы изучение такого инструментария включить в программу обучения HR
И хорошо бы вывести на рынок услугу валидизации процедуры
ПыСыСы. Будут возражения: мол, это очень все сложно – регрессионный анализ, все такое… А я спрошу: а корпоративную культуру измерять не сложно? Задумайтесь по сути: измерять валидность теста очень сложно, а корпоративную культуру нет? Сравните два объекта: тест и корпоративная культура – что сложнее?
Так почему у нас корпоративную культуру мерят все подряд, а регрессионный анализ – единицы?

четверг, 24 мая 2012 г.

Матстатистика для HR-2


Философская часть

Я глубоко уверен, что данные вебинары гораздо ближе приближают участников к измерению корпоративной культуры, лояльности и вовлеченности, чем те, кто заявляют измерение этих самых понятий. При том. Что на вебинарах по матстатистике нет упоминаний корпоративной культуры, вовлеченности, лояльности.
См мой полемичный пост на эту тему Зачем бизнесукорпоративная культура?

Вводная

Сегодня проводил вебинар Матстатистика для HR-2 (по ссылке можно посмотреть презентацию, запись вебинара)
Второй, потому что на первом вебинаре Матстатистика для HR решили превратить вебинар в серию вебинаров со следующей схемой:
После вебинара выполняем домашнее задание, следующий вебинар начинаем с разбора полетов, т.е. разбираем домашнее задание, комментируем, критикуем и т.п…; после чего рассматриваем следующий статистический критерий, практику его применения, кейсы, ограничения применения и т.п.; в конце опять даем домашнее задание и по кругу…

Цель серии

Я здесь без науки попробую обойтись. Хотелось бы глобально, чтобы HR-ы использовали статистические критерии при оценке эффективности обучения, исследованиях и т.п.. В целом это позволит принимать более взвешенные решения в Hr и повысит уровень профессионализма. И мы будем говорить на понятном языке друг другу.
Хочется верить, что так и будет

Содержание

На этом вебинаре в качестве домашнего задания выступал критерий Манна Уитни. Наталья Филимонова, специалист по дистанционному обучению компании Карло Пазолини представила кейс
После разбора кейса рассматривали критерий угловое преобразование фишера. Рассказал несколько кейсов из практики исследования сайта. Кейсы следующие:
·         Сравнение частоты наличия корпоративных блогов у топ-500 компаний и топ 500 быстроразвивающихся компаний США
·         Сравнение частоты запросов «бизнес тренинги» и «психологические тренинг» в Яндексе по России и Украине
·         Сравнение участия/регистрации мужчин/женщин в вебинаре
·         Сравнение активности участия в опросах по отраслям (пример, как несколько признаков можно разбить на два)
В конце предложили тему регрессионного анализа. Если специалист, предложивший тему, согласится выступить – буду благодарен. Я когда-то сам проводил такие исследования в банке, но к сожалению, ничего не сохранил, о чем жалею(((
Сам буду готов выступить с кейсом Крыштановского из книги «Анализ социологических данных с помощью пакета  SPSS»: Александр Олегович проводил регрессионный анализ на студентах факультета социологии. Анализировались данные вступительных экзаменов и академическая успеваемость

Немного статистики

Теперь статистика вебинара. На прошлом вебинаре было 325 регистраций, на этом - 185
Были ли вы на прошлом вебинаре Матстатистика для HR

Применяли ли критерий угловое преобразование фишера

После первого вебинара наша страница на фейсбуке получила три лайка, после этого – семь
За кадром пока остается % выполненных домашних заданий или кейсов.

Резюме

Очень хочется верить, что ощущение не обмануло: на вебинар пришли более «заточенные» участники, чем на первый. Ощущение подтвердится в случае, если домашнее задание выполнит не меньше человек, чем на прошлом вебинаре. А вообще я рассчитываю на 5-6 кейсов.